# Архитектура компьютера ## Лекция 7 ## MoC/2. PLC. MDE. <br/> Машина фон Неймана. ISA Пенской А.В., 2026 --- ### MoC. Функциональные модели <div class="row"><div class="col"> <dl> <dt> Functional models </dt> <dd> вычислитель — это <b>выражение</b> и набор правил его переписывания. Шаг выбирается по образцу: ищем подвыражение, подходящее под правило. Результат: "упрощённое" выражение. </dd> </dl> ------------------ 1. Арифметика 1. **Лямбда-исчисление** <br/> (полнота по Тьюрингу) 1. Combinatory logic 1. General recursive functions 1. Abstract rewriting systems. - См. [Рефал](https://fprog.ru/2011/issue7/) </div><div class="col">  </div></div> ---- <dl> <dt> Лямбда-исчисление (Lambda calculus) </dt> <dd> всё кодируется функциями: числа, логика, структуры данных. </dd> </dl> <div class="row"><div class="col"> 4 вида выражений: 1. переменная: $x$, $y$, $z$ 1. константа: $a$, $b$, $c$ 1. комбинация (вызов): $s\\;t$ 1. абстракция: $\lambda x.s$ 3 вида редукций/подстановки: 1. переименование переменных: $\lambda u.u\\;v \xrightarrow{\alpha} \lambda w.w\\;v$ 1. применение функции: $(\lambda x.s)\\;t \xrightarrow{\beta} s[t/x]$ 1. сокращение аргумента: $\lambda u.v\\;u \xrightarrow{\eta} v$. </div><div class="col">  <!-- .element: height="550px" --> [Пример дизайна ЯП семейства ML](https://www.cl.cam.ac.uk/teaching/Lectures/funprog-jrh-1996/all.pdf) и факториал на чистом лямбда-исчислении. </div></div> --- ### MoC. Параллельные модели <div class="row"><div class="col"> <dl> <dt> Concurrent models </dt> <dd> правила, по которым <b>взаимодействуют компоненты</b>: кто кого ждёт, через что передаются данные, что считается одновременным. </dd> </dl>  </div><div class="col"> 1. **Discrete Event** в синхронных схемах 1. Petri Nets и **Synchronous Data Flow** в ПЛК 1. Actor model в прерываниях 1. Multi-Thread Model в многозадачности 1. Cellular automaton в систолических архитектурах 1. Kahn process networks в потоковых архитектурах </div></div> ---- #### Синхронный поток данных <div class="row"><div class="col"> <dl> <dt> Synchronous Data Flow, SDF </dt> <dd> граф акторов, соединённых очередями. Сколько токенов актор забирает и выдаёт за 1 срабатывание — <b>известно и неизменно</b>. Актор срабатывает по готовности входов. </dd> </dl> ```text ┌───── ●● ──────┐ F(n-2) ▼ │ ┌─────┐ ┌──┴───┐ 1 4 ┌──────┐ │ ADD ├────────►│ FORK ├────────────►│ PACK │ └──▲──┘ └──┬───┘ └──────┘ │ │ └───── ● ───────┘ F(n-1) ``` ● — задержка </div><div class="col"> 1. Статическое расписание, реальное время. 1. Цена: срабатывание не зависит от *значения* токена, ветвление не выражается. 1. У ПЛК это Function Block Diagram. </div></div> ---- #### Дискретное событие <div class="row"><div class="col"> <dl> <dt> Discrete Event, DE </dt> <dd> состояние меняется только в <b>отдельных точках модельного времени</b> — в событиях. Результат события: другие события в будущем. Между событиями — ничего. </dd> </dl> ```python # упорядочена по t queue = [(0, reset)] now = 0 while queue: # ближайшее по времени (t, event) = queue.pop_min() # время прыгает к событию now = t for p in subscribers(event): for (dt, new) in p.react(event, now): queue.push((now + dt, new)) ``` </div><div class="col"> 1. Время модельное, обработка событий, а не секунд. 1. Причинность выражена задержкой. 1. События с одинаковой меткой модель не упорядочивает (недетерминизм). 1. Состояние меняется только в событиях. 1. Что происходит *между* событиями, модель не описывает. </div></div> ---- #### Discrete Event — схемотехника Регистр с защёлкиванием по условию. ```text D_new ──┐ ├──[ MUX ]──► D ──[ DFF ]──┬──► Q ┌───►┘ ▲ ▲ │ │ │ │ │ │ en clk │ │ │ └───────────────────────────────┘ ``` Это ровно RTL (Register Transfer Level): регистры держат состояние, между ними — комбинационные схемы. ---- #### Ключевые отличия схемотехники (DE) <br/> от программирования (RAM) Разница между схемотехникой и программированием — это разница MoC. Следствия: 1. Все процессы между регистрами всегда происходят параллельно. Не читайте код как алгоритм, рисуйте схему. 1. Передача сигнала — физический аналоговый процесс. Сигнал не может не идти. 1. Таблица истинности неполна — результат будет случайным, но будет (и возможно воспроизводимым). 1. Нет понятия "система остановилась". Она всегда работает, если есть питание. ---- #### Примеры реализаций параллельных MoC <div class="row"><div class="col"> Три разных компромисса для распределения вычислений между исполнителями. 1. **OpenMP** — Multi-Thread модель поверх общей памяти, синхронизация неявная. 1. **LabVIEW** — Synchronous Data Flow: граф блоков, данные "текут" по проводам, порядок исполнения определяется готовностью данных. 1. **Lingua Franca** — Discrete Event + Actor: реактивные "reactors" обмениваются событиями с гарантированными временными метками. </div><div class="col">  <!-- .element: height="200px" -->  <!-- .element: height="200px" -->  <!-- .element: height="200px" --> </div></div> --- ### MoC. Применение на практике 1. Формальные модели. Гарантии. 1. Дизайн языков программирования. 1. **Модель-ориентированная инженерия**.  --- ### ПЛК: MoC для производств <div class="row"><div class="col"> <dl> <dt> Программируемый логический контроллер (ПЛК) </dt> <dd> пром. вычислитель с <b>фиксированным циклом сканирования</b>: прочитать входы-посчитать-записать выходы-повторить. </dd> </dl>  </div><div class="col"> <!-- .element: height="160px" --> 1. Все любят релейные схемы, но неудобно. ПЛК — замена. 1. Законченные устройства для встроенного использования. 1. Специализация ввода-вывода, модульность. 1. Выделение инструментальной составляющей. </div></div> ---- #### IEC 61131: схема как программа <div class="row"><div class="col"> <dl> <dt> IEC 61131 </dt> <dd> платформа для ПЛК. Выразительность ограничена ради реального времени и цикла сканирования. </dd> </dl> <dl> <dt> Function Block Diagram </dt> <dd> логическая схема как язык — блоки и провода. Порядок исполнения задаёт готовность данных, а не текст программы: это <b>поток данных</b> (см. SDF выше). </dd> </dl> <dl> <dt> Ladder Diagram </dt> <dd> релейная схема как язык — контакты, катушка, цепь между рейками. Инженер, который читает релейный шкаф, читает и программу. </dd> </dl> </div><div class="col"> 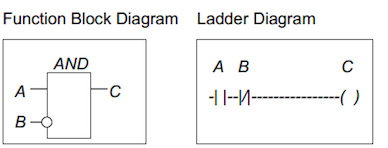 1. Утверждение, выполняемое за цикл сканирования. 1. Возможны произвольные вычисления внутри блоков. 1. Визуальные языки для непрограммистов. </div></div> ---- #### IEC 61131: текст и последовательность <div class="row"><div class="col"> <dl> <dt> Structured Text </dt> <dd> обычный императивный язык. Нужен там, где схемой неудобно: арифметика, циклы, строки. </dd> </dl> <dl> <dt> Sequential Function Chart </dt> <dd> шаги и переходы между ними, то есть FSM. Состояние передаётся между циклами. </dd> </dl> ------------------ 1. Один стандарт — четыре нотации с разными MoC. 1. Дать удобный инструмент с гарантиями. </div><div class="col"> 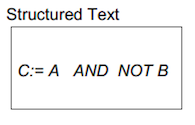 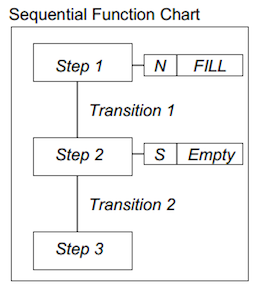 <!-- .element: height="230px" --> </div></div> ---- #### IEC 61499: сеть контроллеров <div class="row"><div class="col"> <dl> <dt> IEC 61499 </dt> <dd> акторная модель в промышленной автоматике: блоки <b>реагируют и шлют события дальше</b>. Где блок физически исполняется, программой не фиксируется. </dd> </dl>  </div><div class="col"> <dl> <dt> Событийные связи </dt> <dd> когда блоку исполняться. </dd> </dl> <dl> <dt> Связи данных </dt> <dd> что именно передаётся. </dd> </dl> -------------- 1. В 61131 порядок задаёт цикл сканирования. 1. В 61499 порядок задают событийные связи. 1. Позволяет задать алгоритм одной программой с поздним размещением блоков по устройствам. 1. Синхронизация устройств автоматическая. </div></div> --- ### Model-Driven Engineering <div class="row"><div class="col"> <dl> <dt> Model-Driven Engineering (MDE) </dt> <dd> систему описывают в <b>модели [вычислений] предметной области</b>, а не в универсальном языке. Код — продукт трансляции. </dd> </dl>  </div><div class="col"> 1. Модель — источник истины (код будет перегенерирован). 1. В основе всегда лежит MoC. 1. Одна модель — несколько платформ. 1. Цена: инструменты узкие и дорогие. Вне своей предметной области обычный код дешевле. 1. Видели в IEC 61131, 61499. 1. В программировании часто называют DSL. </div></div> ---- #### Предметно-ориентированные языки <div class="row"><div class="col"> <dl> <dt> Domain Specific Language (DSL) </dt> <dd> язык, спроектированный для одной прикладной области — специально ограниченный по выразительности в обмен на требуемые свойства. </dd> </dl>  </div><div class="col"> 1. Простота, верификация, специфичность. 1. Качество и специфичность инструментов (подсказки, статический анализ). 1. Доступность для пользователей. --------------- - Structured Query Language (SQL) - Verilog/VHDL — DSL для описания цифровых схем. - Regular Expression (Regex) — DSL для поиска по строкам. - Cascading Style Sheets (CSS) </div></div> ---- #### MDE: Executable UML (xtUML) <dl> <dt> Executable UML (xtUML) </dt> <dd> модель из <b>диаграмм классов, автоматов и Action Language</b> — не чертёж, а исходник: транслятор делает из неё код целевой платформы. </dd> </dl> <div class="row"><div class="col">  <!-- .element: height="250px" -->  <!-- .element: height="250px" --> </div><div class="col"> 1. Транслируется не код в код, а модель в код. 1. В транслятор попадает: 1) <b>модель приложения</b> (что система делает) и 2) <b>элементы трансляции</b> (как это ложится на платформу). 1. Переносимость: нужно поменять только вторую ветку. 1. Верифицируемость модели: конечные автоматы. 1. Тот же контракт, что и в PBD, но в ПО. </div></div> ---- #### MDE: xtUML. Моделирование <div class="row"><div class="col">  <!-- .element: height="200px" -->  <!-- .element: height="200px" --> </div><div class="col"> 1. Домены $\to$ классы $\to$ <b>конечный автомат</b> на класс. 1. На картинке: `Bed` — два состояния, действия в `entry/`. 1. Действия — на Action Language: без привязки к платформе, иначе нет переносимости. 1. "Executable": модель не рисуют, а исполняют. Та же Sequential MoC. </div></div> ---- #### Другие примеры MDE 1. **Lingua Franca** — уже видели: Discrete Event + Actor. 1. **LabVIEW** — уже видели: Synchronous Data Flow. 1. Behavior Driven Development (**BDD**) — сценарий `Given/When/Then` как модель: из него генерируются шаблоны тестов, требования и код не расходятся. 1. **JetBrains MPS** — платформа для своих DSL с проекционным редактированием: пишешь не текст, а сразу структуру. 1. **CASE-технология** — инструменты проектирования ПО ради качества, надёжности и поддерживаемости (отечественный аналог xtUML). --- ## Универсальный процессор <div class="row"><div class="col"> 1. Универсальность <br/> $\neq$ полнота по Тьюрингу. 1. Теоретическая <br/> $\neq$ практическая универсальность. 1. Универсальность противоречит эффективности. </div><div class="col"> <!-- ### Свойства универсального (программируемого) процессора --> Свойства: 1. Hardware/Software 1. Полнота по Тьюрингу 1. Отсутствие "серьезных" ограничений на "объём" SW 1. Изменяемость ПО </div></div> 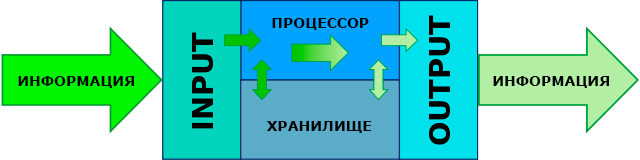 ---- ### Виды процессоров Гибкость и эффективность  <!-- .element: height="300px" --> <div class="row"><div class="col"> (1) Application-Specific Integrated Circuit (2) Coarse-Grained Reconfigurable Arrays <br/> (3) Field-Programmable Gate Array </div><div class="col"> (4) Digital Signal Processor <br/> (5) Graphics Processing Unit <br/> (6) **Central Processing Unit** <br/> </div></div> ---- #### Процессор, контроллер, память <div class="row"><div class="col"> <dl> <dt> [Микро]процессор </dt> <dd> цифровая схема, которая выполняет операции с внешним источником данных (обычно памятью или потоком данных). </dd> </dl> <dl> <dt> [Микро]контроллер </dt> <dd> микросхема, предназначенная для управления электронными устройствами. </dd> <dd> Типичный микроконтроллер сочетает функции процессора и периферийных устройств, содержит ОЗУ и (или) ПЗУ. </dd> </dl> </div><div class="col"> 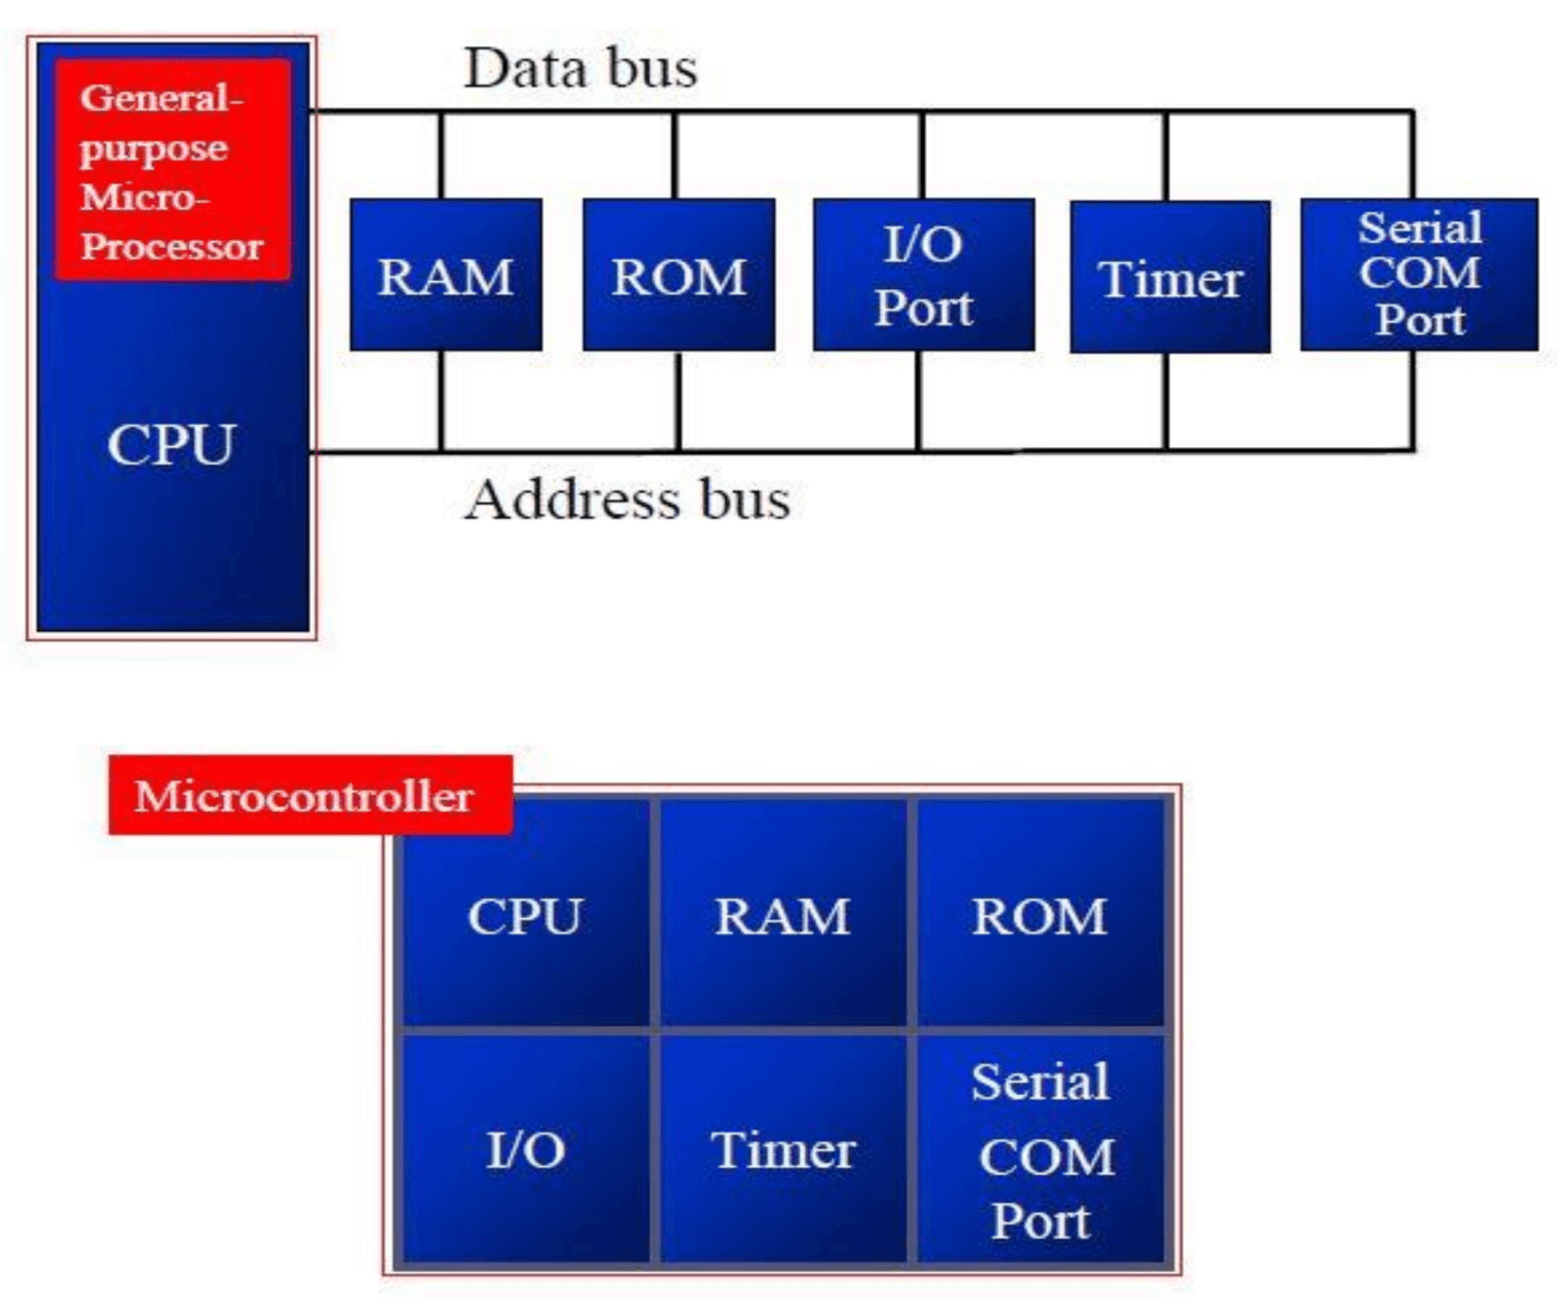 <dl> <dt> Оперативная память (память) </dt> <dd> обычно часть компьютерной памяти, в которой хранится выполняемый машинный код, а также входные, выходные и промежуточные данные. </dd> </dl> </div></div> --- ## Машина фон Неймана <div class="row"><div class="col"> 1. Развитие машины Тьюринга. Ключевые отличия: - лента заменена на Random-Access Memory (RAM); 1. Простота в реализации и производстве: - инструкции и данные объединены. 1. Логическое развитие: процедурное программирование, ООП. </div><div class="col">  </div></div> ---- ### Машина фон Неймана. Особенности 1. Использование **двоичного кодирования**. - Бывает троичное и двоично-десятичное кодирование. 1. **Программное управление**. Последовательное исполнение. - Система прерываний. - Порядок инструкций — условность. 1. **Однородная пассивная память** хранит данные и ПО. - Кеширование, DMA, общая память. 1. **Адресация памяти** компьютера. Random-Access Memory. - Множество адресных пространств. - Адрес не сводится к целому числу сегодня. 1. Возможность **условного перехода**. - Или косвенного перехода. ---- #### Машина фон Неймана. Control Unit и DataPath <div class="row"><div class="col"> <dl> <dt> Control Unit </dt> <dd> компонент центрального процессора (CPU), управляющий работой процессора. CU часто использует двоичный декодер для преобразования закодированных инструкций в управляющие сигналы, координирующие работу остальных блоков. </dd> </dl> <dl> <dt> Datapath </dt> <dd> АЛУ, набор регистров и внутренние шины CPU, по которым данные перемещаются между ними. </dd> </dl> Компоненты модели лаб. 4 </div><div class="col">  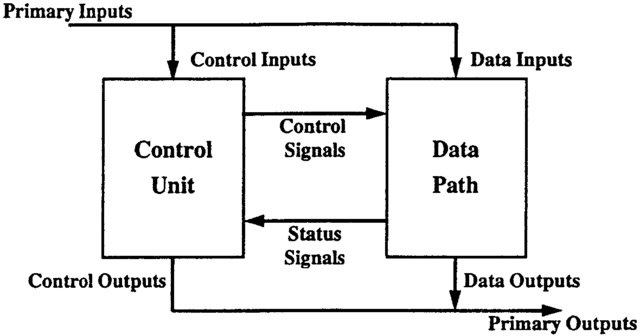 </div></div> --- ### Архитектура процессора <dl> <dt> Архитектура процессора (architecture) </dt> <dd> то, как видит компьютер программист. Определена набором команд (язык), местом нахождения операндов (регистры и память) и вычислительными механизмами (кеш, прерывания...). </dd> </dl> -------------------- 1. Множество разных архитектур: - F18a, PDP-11, x86, SPARC, ARM, RISC-V. - acc32, f32a, risc-iv, m68k, vliw-iv, wasm. 1. Чтобы понять архитектуру, нужно знать её язык. 1. Слова в языке компьютера — "инструкции" или "команды". 1. Словарный запас — "система команд". ---- ### Микроархитектура процессора <dl> <dt> Микроархитектура процессора (microarchitecture) </dt> <dd> соединение простейших цифровых элементов в логические блоки, предназначенные для выполнения команд определенной архитектуры. </dd> </dl> -------------------- Примечания: 1. Описывает, как в процессоре расположены и соединены друг с другом регистры, АЛУ, конечные автоматы, блоки памяти, интерфейсы ввода-вывода и т.п. 1. У архитектуры много микроархитектур, обеспечивающих разное соотношение производительности, цены, сложности. Они бинарно совместимы. --- <div class="row"><div class="col"> #### Система команд <dl> <dt> Instruction Set Architecture (ISA) </dt> <dd> абстрактная модель процессора, формирующая интерфейс взаимодействия между ПО и аппаратурой. </dd> </dl> --------------------- - Обычно — функциональные требования. - Нефункциональные требования (производительность, энергопотребление, задержки, т.п.) — уровень микроархитектуры. </div><div class="col"> 1. адресные пространства и методы адресации, 1. принципы формирования инструкций и логика их работы, 1. типы данных, 1. механизмы обработки прерываний и исключений, 1. механизмы ввода и вывода. 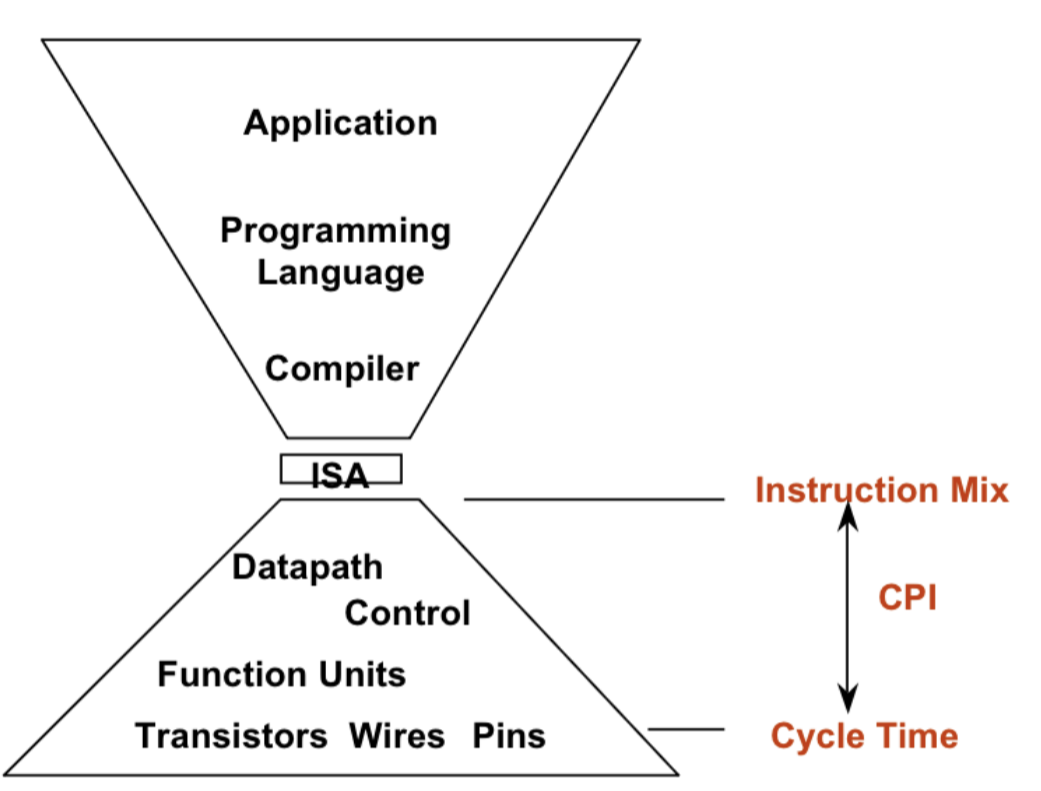 <!-- .element: height="300px" --> </div></div> Notes: ECE C61 Computer Architecture Lecture 3 – Instruction Set - [Meltdown and Spectre](https://meltdownattack.com) - [Edward A. Lee Modeling in Engineering and Science](https://cacm.acm.org/magazines/2019/1/233519-modeling-in-engineering-and-science/fulltext) ---- <div class="row"><div class="col"> #### Виды инструкций 1. **Работа с памятью**: запись констант, копирование данных. 2. **Арифметические, логические и битовые** операции. 3. **Управляющие операции**: безусловный, условный и косвенный переходы, вызов и возврат из подпрограмм. 4. **Инструкции сопроцессоров**: - Загрузка и выгрузка. - Управление. </div><div class="col"> ##### Пример кодирования инструкций 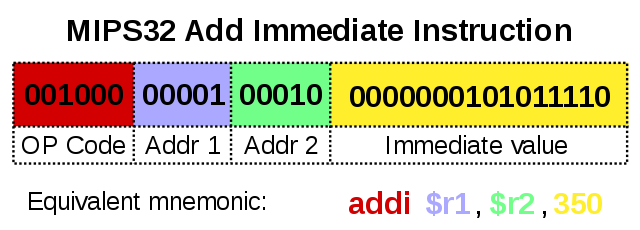 - `OP Code` — код операции. - `Addr 1/2` — регистры общего назначения. - `Immediate value` — непосредственное значение. - `$r1` `<- $r2 + 350` </div></div> --- ### Принципы формирования инструкций и логика их работы 1. Accumulator Architectures 1. Register-to-Memory Architectures 1. Register-to-Register Architectures 1. Memory-to-Memory Architectures 1. Stack Architectures Источник: ECE C61 Computer Architecture Lecture 3 — Instruction Set ---- #### Accumulator Architectures (`acc32`)  ---- #### Register-to-Memory Architectures (`m68k`)  ---- #### Register-to-Register: Load-Store Architectures (`risc-iv`)  ---- #### Memory-to-Memory Architectures (`-`)  ---- #### Stack Architectures (`f32a`, `wasm-32`)  --- ### Система команд и линейная функция <div class="row"><div class="col"> ```asm load ACC <- A ; acc mul ACC <-* X ; 1 operands add ACC <-+ B store Y <- ACC ; (1) ``` ```asm load R1 <- A ; reg-to-mem mul R1 <- R1 * X ; 1 operands add R1 <- R1 + B store Y <- R1 ; (2) ``` ```asm load R1 <- A ; reg-to-reg load R2 <- X ; 2 operands load R3 <- B mul R4 <- R1 * R2 add R5 <- R4 + R3 store Y <- R5 ; (3) ``` ```asm load R1 <- A ; reg-to-reg load R2 <- X ; 3 operands load R3 <- B lfn R4 <- R1 * R2 + R3 store Y <- R4 ; (4) ``` </div><div class="col"> $Y = A * X + B$ ```asm mul R1 <- A * X ; reg-to-mem add Y <- R1 + B ; 2 operands (5) ``` ```asm lfn Y <- A * X + B ; mem-to-mem ; 3 operands (6) ``` ```forth A @ X @ * \ stack, 0 operands (7) B @ + Y ! \ @ - read, ! - write ``` Что лучше? - (1) — начало - CISC (2, 4, 5, 6) - RISC (3) - Stack (7) </div></div> Notes: зависит от алгоритма, неплохо бы оптимизировать под задачу. ---- ### Модель выч. процесса (программа) 1. Последовательная модель вычислений. 2. Шаг определяется инструкцией из памяти. 3. Результат: изменение состояния процессора (памяти). ```text | Label | Instruction | Comment | | --------------- | --------------------- | ------------------------------ | | _start: | movea.l 0x80, A0 | A0 <- 0x80 (адрес ввода) | | | movea.l 0x84, A1 | A1 <- 0x84 (адрес вывода) | | | move.l (A0), D0 | D0 <- [A0] (n) | | | move.l D0, D1 | D1 <- D0 | | loop: | sub.l 1, D1 | D1 <- D1 - 1 | | | beq end | если D1 = 0, перейти на end | | | mul.l D1, D0 | D0 <- D0 * D1 | | | jmp loop | перейти на loop | | end: | move.l D0, (A1) | [A1] <- D0 | | | halt | Остановить выполнение | ``` > В ассемблере M68k (симулятор [Wrench](https://github.com/ryukzak/wrench)). ---- #### Вычислительный процесс (трасса) (очерёдность смены состояний процессора) ```text 1. {A0: x, A1: x, D0: x, D1: x} Выполняется movea.l 0x80, A0 2. {A0: 0x80, A1: x, D0: x, D1: x} Выполняется movea.l 0x84, A1 3. {A0: 0x80, A1: 0x84, D0: x, D1: x} Выполняется move.l (A0), D0 4. {A0: 0x80, A1: 0x84, D0: 3, D1: x} Выполняется move.l D0, D1 4.1. {D0: 3, D1: 3} Выполняется loop | sub.l 1, D1 4.2. {D0: 3, D1: 2} Выполняется beq end, D1 не равно 0, выполняем следующую инструкцию. 4.3. {D0: 3, D1: 2} Выполняется mul.l D1, D0 4.4. {D0: 6, D1: 2} Выполняется jmp loop 4.5. {D0: 6, D1: 2} Выполняется loop | sub.l 1, D1 4.6. {D0: 6, D1: 1} Выполняется beq end, D1 не равно 0, выполняем следующую инструкцию. 4.7. {D0: 6, D1: 1} Выполняется mul.l D1, D0 4.8. {D0: 6, D1: 1} Выполняется jmp loop 4.9. {D0: 6, D1: 1} Выполняется loop | sub.l 1, D1 4.10. {D0: 6, D1: 0} Выполняется beq end, D1 равно 0, переходим на end. 5. {A0: 0x80, A1: 0x84, D0: 6, D1: 0} Выполняется end | move.l D0, (A1) 6. Выполняется halt, Остановить выполнение ``` Регистры `A0`, `A1`, `D0`, `D1` — брошены в "случайном" состоянии. --- #### Другие вариации системы команд (не совсем фон Нейман) 1. Управляющие сигналы процессора под видом команды (NISC). 1. Группа команд под видом одной команды (VLIW). 1. High-level language computer architecture. 1. Действие над шиной данных (TTA). 1. Команды без последовательного исполнения (редукционные). 1. Система команд из одной команды (URISC). 1. Управляющие сигналы процессоров под видом команды (NITTA). --- ### Влияние машины фон Неймана > Can Programming be Liberated from the von Neumann Style? > > — Backus, John. 1977 Turing Award Lecture 1. Элементы архитектуры присутствуют в подавляющем большинстве процессоров и средств разработки. 1. "Уши" торчат из большинства средств разработки (структурное программирование, ООП). Ловушка обратной совместимости. 1. В чистом виде практически не встречается: - Память команд и данных. - Система прерываний. - Параллелизм. Спекулятивные вычисления. - Иерархия памяти. Виртуальная память. - ...